Позначка: ChatGPT

  • Ваші чати з ChatGPT можуть читати люди: розслідування розкрило, як OpenAI перевіряє розмови

    Ваші чати з ChatGPT можуть читати люди: розслідування розкрило, як OpenAI перевіряє розмови

    Розмови з ChatGPT, які користувачі часто сприймають як приватний діалог із програмою, у певних випадках можуть потрапляти на перегляд до людей. За даними розслідування 404 Media, сотні зовнішніх підрядників працюють із реальними розмовами користувачів OpenAI, оцінюючи відповіді чатбота, шукаючи проблеми у його поведінці та допомагаючи покращувати майбутні версії моделей.

    Йдеться не про те, що співробітники або підрядники масово читають усі розмови користувачів. OpenAI офіційно зазначає, що доступ до контенту має обмежена кількість уповноважених працівників і довірених постачальників послуг та лише за визначених умов. Однак розслідування показує, що серед матеріалів, які потрапляють до рецензентів для покращення моделей, можуть бути реальні чати, зокрема такі, де люди діляться особистими або чутливими даними.

    За інформацією 404 Media, внутрішній проєкт отримав назву Project Lily. Підрядники мають оцінювати не лише правильність відповідей ChatGPT, а й те, наскільки модель дотримується бажаної манери спілкування.

    Зокрема, рецензенти повинні допомагати боротися із двома проблемами, які давно обговорюють розробники мовних моделей: надмірною підлабузливістю та антропоморфізацією, коли чатбот говорить або поводиться так, ніби має власні почуття, свідомість чи особисті стосунки з користувачем.

    Робота виглядає приблизно так: людина отримує фрагмент реальної взаємодії користувача з ChatGPT, визначає, чого той намагався досягти, оцінює відповідь моделі та описує її недоліки. За даними публікацій, які переказують розслідування 404 Media, відповіді можуть оцінювати за шкалою від одного до семи.

    Окремо рецензентів просять звертати увагу на фактичні помилки та на відсутність джерел у відповідях на чутливі теми, зокрема медичні, юридичні та фінансові питання.

    Знайдений журналістами підрядник розповів, що працює у Північній Америці й отримує понад $50 за годину. Роботу він знайшов через рекрутингову компанію Crossing Hurdles, а сама оплата, за даними розслідування, проходить через платформу Mercor.

    Відкриті вакансії Crossing Hurdles справді підтверджують характер такого роду роботи. Компанія шукає фахівців, які мають аналізувати й анотувати дані, оцінювати відповіді штучного інтелекту, перевіряти їхню релевантність і точність та надавати письмовий фідбек. У низці вакансій заявлена ставка від $50 до $90 за годину, а в окремих спеціалізованих ролях — і вище.

    Найбільш чутливим питанням є те, що саме бачать такі рецензенти.

    OpenAI заявляє, що перед використанням даних для покращення моделей вживає заходів для зменшення обсягу персональної інформації. У своєму офіційному FAQ компанія зазначає, що окремі частини контенту можуть передаватися довіреним постачальникам послуг для анотації даних і забезпечення безпеки. Такі постачальники мають дотримуватися вимог щодо конфіденційності й захисту інформації.

    Водночас повністю автоматично видалити всі можливі особисті дані складно.

    404 Media повідомляє, що OpenAI використовує фільтри для очищення матеріалів перед передачею рецензентам, але сама система може пропускати нетипові ідентифікатори, географічні дані або інформацію, яку алгоритм не розпізнав як приватну. Саме тому в окремих випадках люди, які перевіряють чати, можуть побачити чутливі подробиці.

    При цьому підрядникам, за повідомленнями журналістів, не показують ім’я власника акаунта як частину звичайного процесу рецензування.

    Однак навіть без імені сам текст розмови іноді здатен містити достатньо інформації, щоб розкрити багато про людину: місце роботи, проблеми у стосунках, стан здоров’я, фінансові питання, службові документи або інші персональні обставини.

    Саме це й робить ситуацію чутливою з погляду конфіденційності.

    Водночас важливо, що сама можливість людського перегляду не була повністю прихованою політикою OpenAI. На офіційному сайті компанії зараз прямо зазначено: обмежена кількість уповноважених працівників OpenAI та довірених постачальників може отримувати доступ до контенту користувачів для розслідування зловживань, підтримки, юридичних питань або покращення моделей — якщо користувач не відмовився від такого використання даних.

    Ключове значення тут має налаштування Improve the model for everyone — «Покращувати модель для всіх».

    У персональних версіях ChatGPT контент може використовуватися для навчання і вдосконалення моделей. Користувач може вимкнути цю функцію у Settings → Data Controls → Improve the model for everyone. Після вимкнення нові розмови залишатимуться в історії, однак OpenAI заявляє, що не використовуватиме їх для навчання моделей.

    Важлива деталь: відмова стосується нових розмов після зміни налаштування. Тобто вона не є ретроактивною для контенту, який раніше вже міг бути використаний у процесах покращення моделей.

    Крім того, є виняток щодо добровільного фідбеку. Навіть якщо користувач вимкнув навчання на своїх чатах, але натискає «подобається» або «не подобається» під конкретною відповіддю і надсилає відгук, пов’язана з ним розмова може використовуватися для вдосконалення системи.

    Для більш чутливих тем OpenAI також пропонує Temporary Chat.

    Такі розмови не з’являються в історії, не використовують і не створюють пам’ять та, за офіційною інформацією компанії, не використовуються для навчання моделей. OpenAI окремо позиціонує Temporary Chat як варіант для ситуацій, коли користувач не хоче зберігати розмову.

    Інші правила діють для бізнес-клієнтів.

    OpenAI заявляє, що за замовчуванням не використовує для навчання моделі дані ChatGPT Business, ChatGPT Enterprise та API. Такі клієнти можуть окремо погодитися на передачу даних, але стандартно вони виключені з навчального процесу.

    У FAQ також зазначені користувачі освітніх корпоративних продуктів: для Business, Enterprise та Edu діють додаткові обмеження щодо використання даних для тренування.

    Розслідування 404 Media звернуло увагу ще на одну проблему — психологічне сприйняття чатботів.

    Користувач бачить текстове поле та отримує миттєву відповідь від ШІ, через що легко виникає відчуття розмови «один на один». Деякі люди прямо пишуть ChatGPT, що інформація є секретною або просять його «нікому не розповідати».

    Однак подібна фраза в чаті сама по собі не створює технічного режиму конфіденційності й не змінює політику обробки даних.

    Тобто написати чатботу «це між нами» недостатньо, щоб заборонити використання розмови відповідно до налаштувань акаунта.

    З погляду користувача це одна з найважливіших деталей усієї історії.

    OpenAI прямо рекомендує не передавати в ChatGPT інформацію, яку користувач не хотів би, щоб переглядали або використовували сторонні особи. На офіційних сторінках компанії також зазначено, що дані можуть використовуватися для вдосконалення моделей залежно від налаштувань користувача.

    Подібна практика не є унікальною для OpenAI.

    За даними 404 Media, Anthropic підтвердила використання людських рецензентів для вдосконалення Claude, однак компанія заявила, що це стосується користувачів, які погодилися допомагати покращувати модель. Перед передачею розмов на перевірку Anthropic, за її словами, видаляє ідентифікатори акаунта, зокрема email.

    Отже, сенсаційне формулювання про те, що «підрядники OpenAI читають приватні чати», потребує важливого уточнення.

    Немає підтверджень, що підрядникам надають необмежений доступ до акаунтів або що хтось довільно відкриває будь-які розмови користувачів. Йдеться про відібрані матеріали, які використовують у процесах оцінювання та вдосконалення систем, із технічними й організаційними обмеженнями доступу.

    Але водночас головний висновок розслідування залишається незручним для користувачів: реальну розмову з ChatGPT за певних умов дійсно може побачити людина, і автоматичне приховування персональної інформації не гарантує, що жодна чутлива деталь ніколи не потрапить до рецензента. Цю саму можливість зараз підтверджує й офіційна документація OpenAI.

    Для тих, хто регулярно обговорює з ChatGPT особисті, медичні, юридичні, фінансові або корпоративні питання, висновок доволі практичний: варто перевірити налаштування Data Controls, вимкнути використання нових чатів для покращення моделі, якщо це важливо, а для особливо чутливих розмов користуватися Temporary Chat і не вставляти без потреби паролі, номери документів, банківські дані чи конфіденційні робочі матеріали.

    Історія Project Lily показує головне: за сучасними системами ШІ стоять не лише алгоритми, дата-центри та програмісти. Значну частину того, що користувач сприймає як «розумну поведінку» чатбота, досі формують люди, які оцінюють відповіді, виправляють помилки та навчають модель поводитися краще.

    І саме на перетині цієї людської участі та величезного обсягу особистої інформації виникає нова дискусія про те, наскільки приватною насправді може бути розмова зі штучним інтелектом.
  • У роботі ChatGPT стався збій: користувачі повідомляли про проблеми із запитами

    У роботі ChatGPT стався збій: користувачі повідомляли про проблеми із запитами

    У четвер, 3 вересня, користувачі ChatGPT у різних країнах почали повідомляти про проблеми з роботою популярного чат-бота OpenAI. Частина користувачів не могла нормально надсилати запити або отримувала повідомлення про помилки, а в окремих випадках сервіс працював повільніше, ніж зазвичай.

    Повідомлення про проблеми надходили як від користувачів вебверсії ChatGPT, так і від тих, хто користується сервісом через застосунки. Незалежні системи моніторингу також зафіксували підвищення кількості повідомлень про несправності. Зокрема, StatusGator повідомляє, що 3 вересня виявив проблеми з ChatGPT, пов’язані із завантаженням сервісу та обробкою запитів.

    Водночас ситуація виявилася дещо складнішою, ніж просто повне падіння ChatGPT. Офіційна сторінка статусу OpenAI станом на вечір 3 вересня повідомляє, що системи компанії працюють у штатному режимі й компанія наразі не знає про активні проблеми, які впливали б на її сервіси.

    При цьому протягом цієї доби OpenAI вже офіційно фіксувала окремий інцидент. Йшлося про підвищений рівень помилок у ChatGPT Work Mode. Компанія повідомила про початок розслідування проблеми о 00:04, а вже о 00:10 оголосила, що роботу всіх постраждалих компонентів повністю відновлено.

    Таким чином, ранковий інцидент, який офіційно підтвердила OpenAI, і повідомлення користувачів про проблеми ввечері не варто автоматично вважати одним і тим самим збоєм. На момент написання матеріалу OpenAI не опублікувала на своїй сторінці статусу окремого повідомлення про масштабну вечірню аварію ChatGPT.

    Сторонні сервіси моніторингу, однак, фіксували проблеми з ChatGPT протягом 3 вересня. Down for Everyone or Just Me повідомляє про період підвищеної кількості скарг користувачів, серед яких найчастіше згадувалися помилки під час роботи із сервісом. На момент останньої перевірки цей ресурс також уже не визначав ChatGPT як недоступний.

    Тому користувачам, у яких ChatGPT продовжує не відповідати, варто враховувати, що проблема може бути тимчасовою або стосуватися лише частини інфраструктури, регіонів, тарифів чи функцій. Сама OpenAI наголошує, що показники доступності на її статус-сторінці є агрегованими, а фактична доступність сервісу для конкретного користувача може відрізнятися залежно від тарифу, моделі та функцій, якими він користується.

    Це не перша проблема з ChatGPT останнім часом. 1 вересня OpenAI повідомляла про підвищений рівень помилок у розмовах для користувачів тарифів Free та Go. Компанія застосувала необхідні заходи, після чого оголосила про повне відновлення роботи. 2 вересня також виникали проблеми зі створенням нових облікових записів, які OpenAI згодом усунула.

    Причину вечірніх скарг користувачів 3 вересня OpenAI на момент написання матеріалу офіційно не називала. Тому твердження про перевантаження серверів через «мільярди запитів» як безпосередню причину саме цього збою наразі було б передчасним.

  • Bolt зайшов прямо в ChatGPT: українці вже можуть планувати поїздки через ШІ

    Bolt зайшов прямо в ChatGPT: українці вже можуть планувати поїздки через ШІ

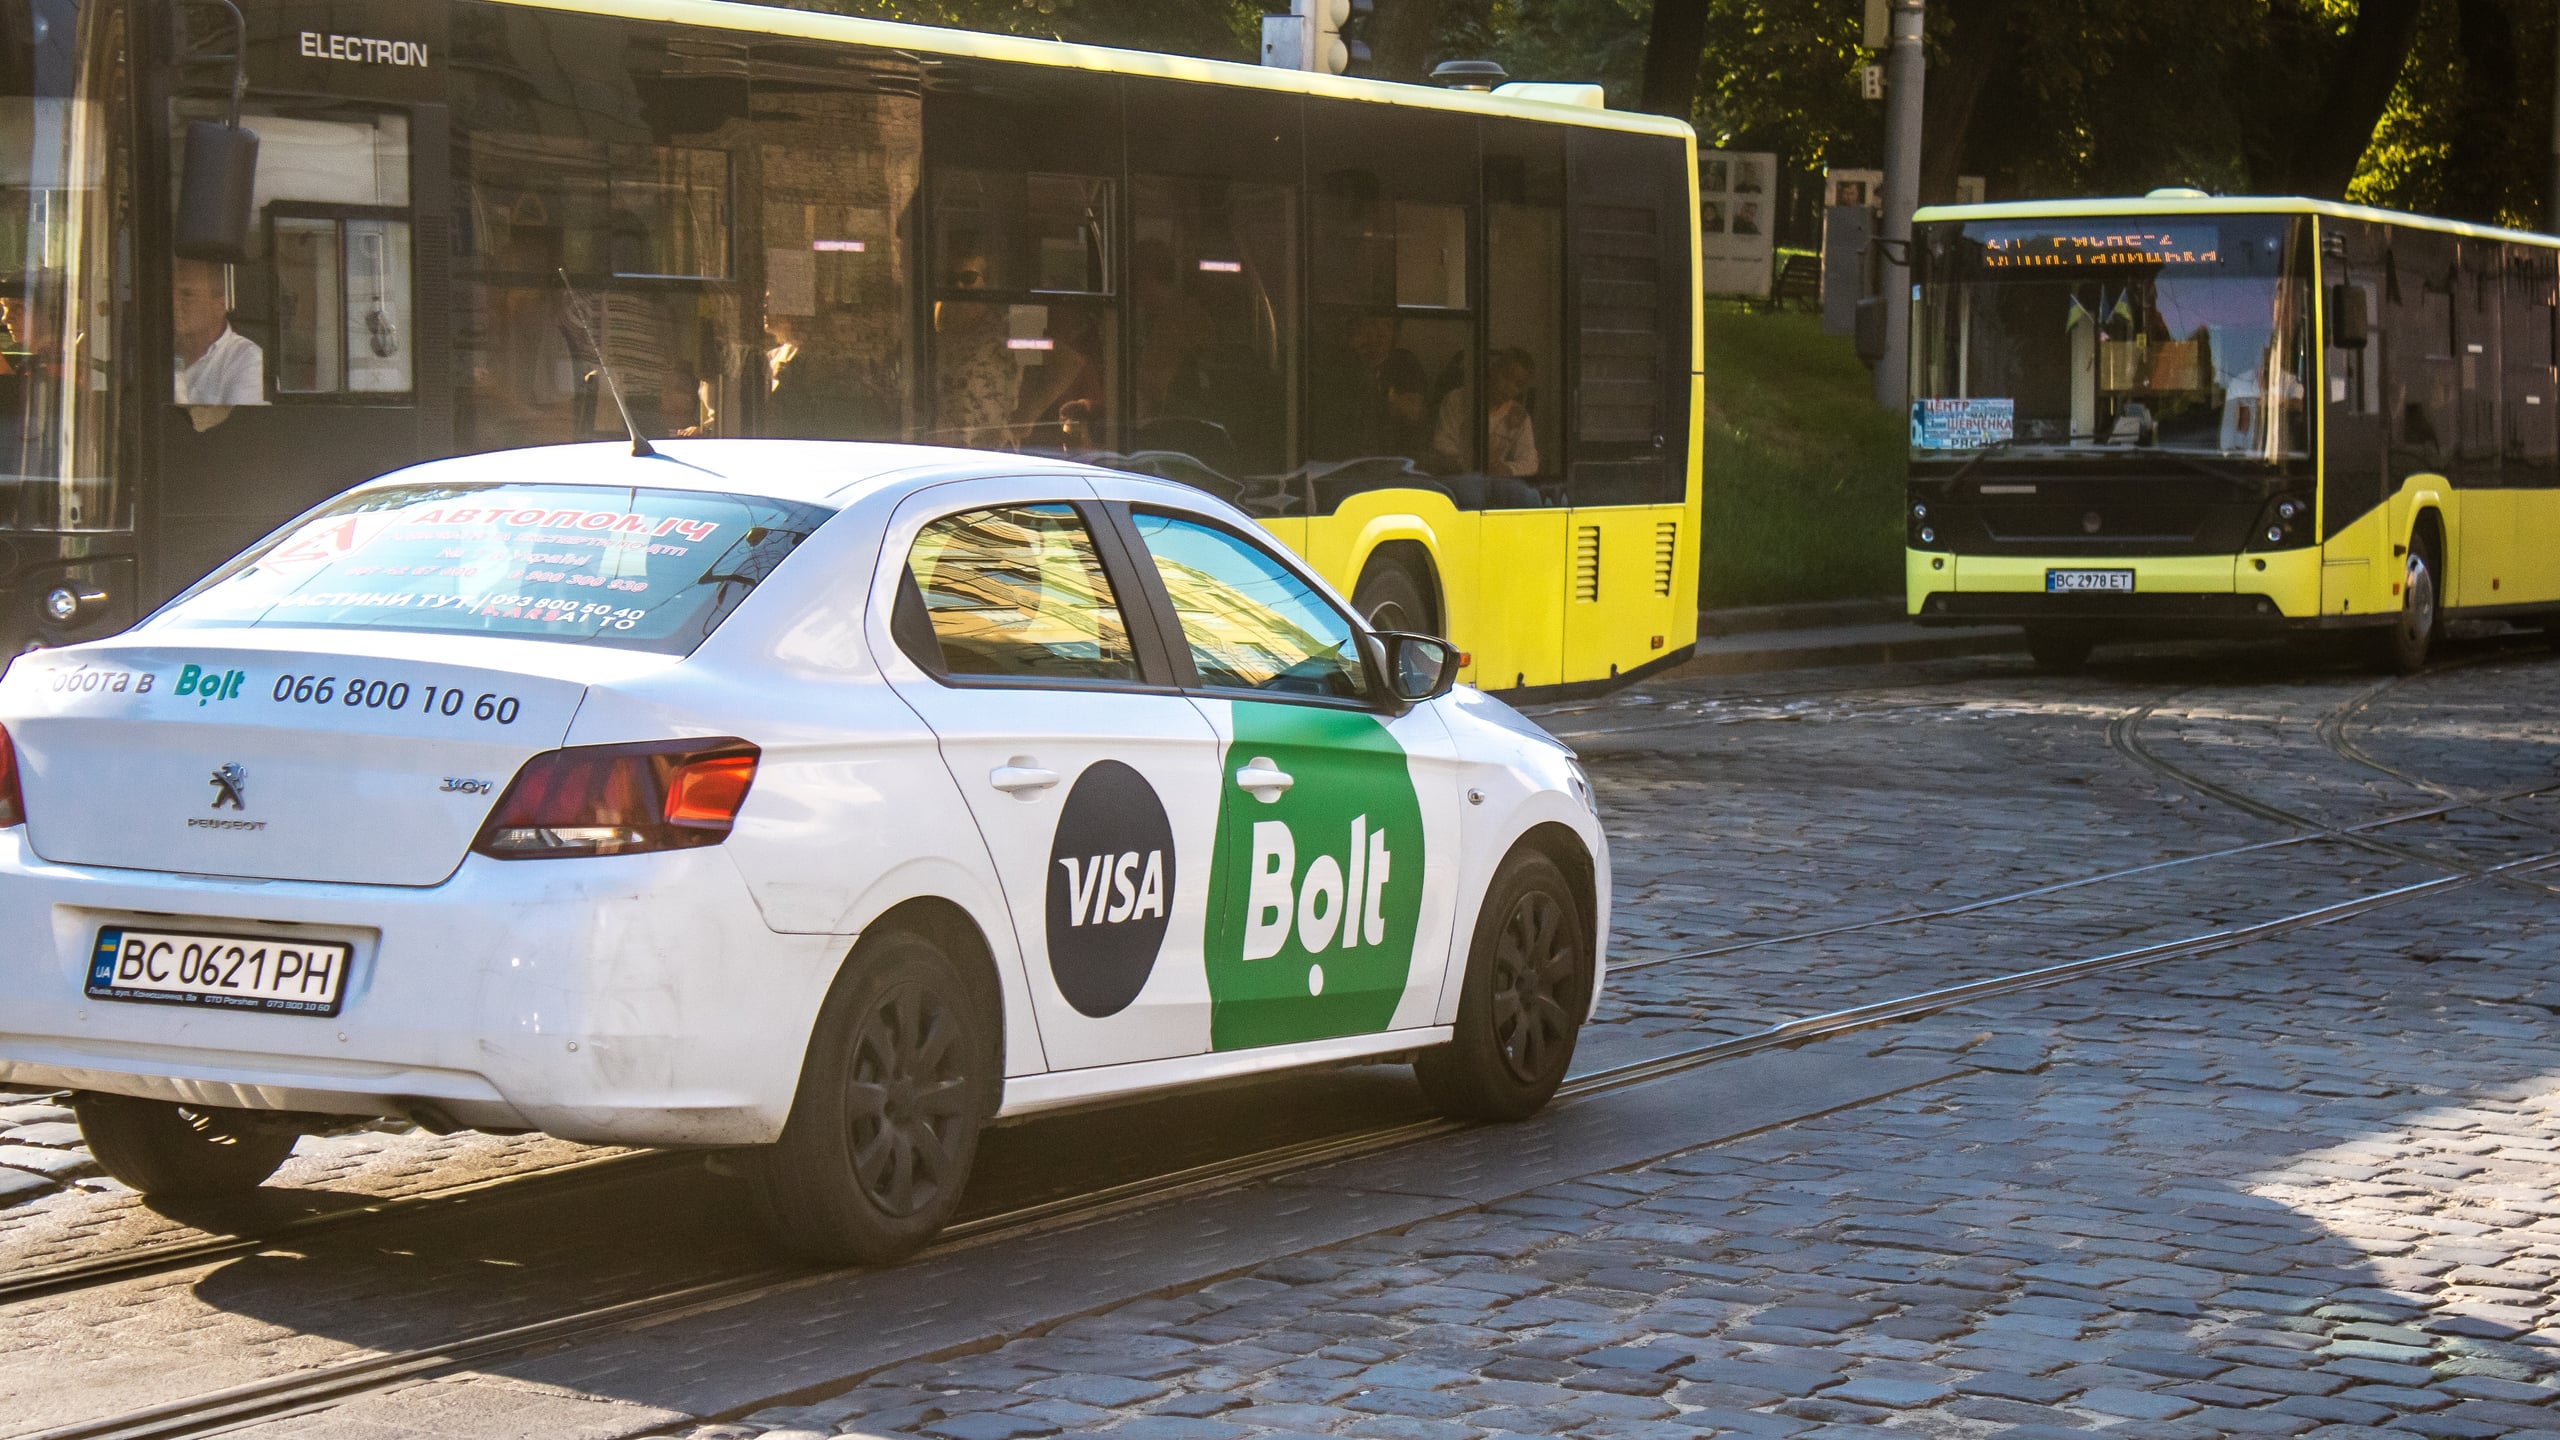
    Сервіс міської мобільності Bolt запустив інтеграцію з ChatGPT, яка дозволяє користувачам в Україні та низці європейських країн готувати поїздку просто у розмові з чатботом. Тепер можна запитати орієнтовну вартість маршруту, порівняти доступні категорії автомобілів, уточнити місце посадки та передати сформоване замовлення у застосунок Bolt. Остаточне підтвердження і оплата поки що відбуваються саме в мобільному застосунку, однак компанія планує піти далі й додати можливість оплачувати поїздки безпосередньо через ChatGPT.

    Про запуск в Україні повідомила компанія Bolt. Інтеграція стала доступною одночасно у країнах Європейського Союзу, Великій Британії, Швейцарії, Норвегії, Україні та Азербайджані. Аналогічний запуск уже підтвердили європейські профільні видання.

    Для користувача механіка виглядає максимально просто. Після підключення відповідного плагіна Bolt у ChatGPT можна сформулювати запит звичайною мовою — наприклад, попросити порахувати вартість поїздки до залізничного вокзалу або підготувати Bolt до певної адреси.

    ChatGPT передасть запит інтеграції, покаже доступні варіанти та допоможе підготувати параметри маршруту. Коли користувач визначиться, дані відкриються у Bolt, де й потрібно буде остаточно підтвердити виклик автомобіля.

    Це ще не повноцінне замовлення таксі всередині ChatGPT

    Попри гучне формулювання про бронювання через ChatGPT, є важливе уточнення: сьогодні користувач усе ще не може пройти весь шлях від запиту до оплати, не залишаючи чат.

    Інтеграція фактично бере на себе підготовчий етап.

    Вона може допомогти визначити маршрут, показати попередню ціну, порівняти категорії автомобілів, оцінити час прибуття водія та підібрати зручну точку посадки. Після цього дані передаються до застосунку Bolt.

    Саме там користувач підтверджує замовлення та обирає спосіб оплати.

    Це відповідає і звичайній логіці сервісу Bolt: безпосередньо в його застосунку пасажир вказує пункт призначення, за потреби додає зупинки, обирає категорію й лише після цього підтверджує поїздку.

    Тому поки що ChatGPT варто сприймати як новий «вхід» до сервісу Bolt, а не як повну заміну його застосунку.

    Наступний крок — оплата прямо у ChatGPT

    Найцікавішою частиною плану є саме наступний етап інтеграції.

    Bolt повідомляє, що пізніше у 2026 році хоче дати користувачам можливість не лише готувати маршрут у чаті, а й завершувати оплату безпосередньо в ChatGPT.

    Якщо це буде реалізовано, взаємодія виглядатиме вже значно ближче до класичного AI-агента: користувач просто повідомляє, куди хоче їхати, а система самостійно виконує більшість технічних кроків.

    Саме в цьому напрямку зараз розвивається екосистема ChatGPT. Після оновлення структури інтеграцій у липні 2026 року зовнішні сервіси в ChatGPT працюють через плагіни, які можуть містити застосунки та інші інструменти для виконання конкретних дій. Такі застосунки можуть не лише шукати інформацію, а й виконувати зовнішні дії від імені користувача, якщо він надав необхідні дозволи.

    Саме ця архітектура робить можливими сценарії, коли чат поступово перетворюється з довідкового сервісу на інтерфейс для взаємодії з реальними послугами.

    ChatGPT може навіть підказати, де краще сісти в авто

    Однією з менш очевидних функцій нової інтеграції є підбір точки посадки.

    Для великих вокзалів, аеропортів, торгових центрів чи складних транспортних розв’язок це може мати практичне значення. Замість того щоб вручну пересувати позначку на карті та шукати, де водій реально зможе зупинитися, система може запропонувати оптимальніший варіант.

    Bolt пояснює це як спосіб скоротити час очікування та зробити зустріч пасажира з водієм простішою. Європейські видання, які описували запуск, також зазначають, що ChatGPT може показувати приблизний час прибуття автомобіля та порівнювати категорії поїздок.

    Водночас попередня ціна не є гарантованою.

    У Bolt діє динамічне ціноутворення: якщо попит перевищує кількість доступних водіїв — наприклад, у годину пік, під час великих заходів або складних погодних умов — тарифи можуть змінюватися. Тому сума, яку користувач побачив під час планування в ChatGPT, потенційно може відрізнятися від фінальної ціни у застосунку.

    Bolt запустив функцію не лише для України

    Особливість релізу полягає в його масштабі.

    Інтеграцію не тестують спочатку в одному місті чи окремій країні. Bolt запустив можливість одразу на великій групі своїх ринків — у ЄС, Великій Британії, Швейцарії, Норвегії, Україні та Азербайджані.

    У компанії наголошують, що це перший настільки широкий запуск для великого європейського ride-hailing сервісу через ChatGPT.

    Для Bolt масштаб має особливе значення.

    Компанія працює вже у більш ніж 50 країнах і 850 містах, а її платформою користувалися понад 200 млн клієнтів. Bolt також повідомляє про більш ніж 4,5 млн партнерів — водіїв, кур’єрів і ресторанів.

    Тобто інтеграція ChatGPT отримує не експериментальний стартап із кількома тисячами користувачів, а один із найбільших сервісів міської мобільності у Європі.

    Чому Bolt взагалі пішов у ChatGPT

    За новою функцією стоїть значно більший тренд.

    Технологічні компанії поступово переходять від генеративного ШІ, який переважно відповідає на запитання та створює контент, до агентського ШІ, здатного виконувати послідовність дій.

    Раніше користувач сам мав відкрити застосунок, знайти адресу, перевірити маршрут, вибрати тариф і натиснути кнопку бронювання.

    У новій моделі він формулює лише мету: «Мені потрібно до вокзалу».

    Система повинна сама визначити, які дії необхідні для її виконання.

    Саме тому транспорт, бронювання готелів, ресторанів, покупки та доставка стають одними з найбільш очевидних сфер для розвитку AI-агентів.

    OpenAI прямо описує застосунки в ChatGPT як інтеграції, які можуть підключати зовнішні інструменти та виконувати дії, а не лише повертати інформацію.

    Бізнес масово експериментує з AI-агентами

    2026 рік уже став одним із переломних для корпоративного ШІ.

    За даними глобального опитування PwC серед 4454 керівників компаній у 95 країнах, лише 12% CEO повідомили, що використання ШІ вже одночасно дало їм і зростання доходів, і зниження витрат.

    Ще третина керівників бачить хоча б один із цих позитивних ефектів, тоді як 56% поки не отримали суттєвої фінансової віддачі.

    Це добре показує нинішню фазу ринку: технології розвиваються дуже швидко, але їхнє реальне масштабування лише починається.

    Gartner водночас попереджає, що автономність AI-агентів створює нові проблеми з безпекою та управлінням. Компанія прогнозує, що вже до 2027 року близько 40% підприємств можуть знизити рівень автономності або взагалі відмовитися від частини автономних агентів через проблеми з контролем та governance.

    Тому інтеграція Bolt показова ще й тим, що компанія на першому етапі залишає фінальне підтвердження поїздки за людиною.

    Користувач усе ще контролює фінальне рішення

    Саме ця деталь може бути ключовою з погляду безпеки.

    ChatGPT не повинен самостійно замовляти автомобіль на неправильну адресу або списувати гроші через невірно зрозумілий запит.

    Сьогодні система передає параметри в Bolt, але користувач бачить їх перед підтвердженням.

    Таким чином, ШІ виконує роль асистента, а не повністю автономного агента.

    Це особливо важливо в транспорті, де помилка може означати не просто невдалу відповідь у чаті, а неправильно вказану точку посадки, зайві витрати чи затримку перед поїздом або літаком.

    Подібний підхід — коли AI готує дію, але людина її остаточно підтверджує — зараз залишається одним із найбільш практичних способів запровадження агентських систем.

    Для України функція має окреме значення

    Україна увійшла до першої хвилі запуску одночасно з великими ринками ЄС і Великої Британії.

    Це показово ще й через популярність самого ChatGPT серед українців.

    За даними, які наводить Forbes Ukraine із посиланням на дослідження Webpromo, застосунок ChatGPT посів друге місце за кількістю завантажень в App Store і Google Play в Україні у першому півріччі 2026 року.

    ШІ-сервіси також увійшли до провідних категорій за споживчими витратами: серед популярних продуктів називали ChatGPT, Claude, Grok та інші сервіси з генеративним ШІ.

    Тому для Bolt інтеграція потенційно відкриває ще один великий канал залучення клієнтів — користувачеві більше не обов’язково починати свій маршрут саме з відкриття застосунку таксі.

    Застосунки поступово можуть стати «невидимими»

    Саме це може бути найважливішим довгостроковим наслідком подібних інтеграцій.

    Зараз користувач відкриває окремий застосунок майже для кожної дії: Bolt — для поїздки, сервіс бронювання — для готелю, доставку — для їжі, банкінг — для платежу.

    Агентські системи пропонують іншу модель: людина залишається в одному чаті, а сам асистент звертається до необхідних сервісів.

    У такому сценарії бренди нікуди не зникають, однак їхні мобільні застосунки поступово перестають бути єдиним основним інтерфейсом взаємодії з клієнтом.

    Bolt фактично одним із перших великих сервісів міської мобільності в Європі почав перевіряти цю модель у масштабі.

    Поки що революція виглядає досить буденно: ChatGPT рахує приблизну ціну, допомагає вибрати місце посадки й перекидає користувача в Bolt.

    Але наступний етап — оплата і підтвердження послуги безпосередньо в чаті — вже набагато ближчий до світу, де користувач не «відкриває застосунки», а просто говорить ШІ, що йому потрібно зробити.

  • Apple звинуватила OpenAI у крадіжці комерційних таємниць

    Apple звинуватила OpenAI у крадіжці комерційних таємниць

    Компанія Apple подала позов до федерального суду Каліфорнії проти OpenAI та двох її співробітників, звинувативши розробника ChatGPT у незаконному заволодінні комерційними таємницями, конфіденційною документацією та технологічними напрацюваннями, що стосуються майбутніх апаратних продуктів компанії. У корпорації заявляють, що OpenAI нібито систематично використовувала чинних і колишніх працівників Apple для отримання доступу до секретної інформації, яка могла бути використана під час створення власних пристроїв зі штучним інтелектом. У компанії називають це не окремими порушеннями, а цілеспрямованою схемою, яка, за їхніми твердженнями, діяла протягом тривалого часу.

    Про це повідомляє Financial Times.

    У заяві Apple наголошується, що компанія має серйозні підстави вважати, що її інтелектуальна власність була незаконно використана.

    «З’явилися вагомі докази того, що особи, які працюють в OpenAI, незаконно заволоділи секретною та конфіденційною інформацією Apple щодо наших неанонсованих технологій, процесів і продуктів. Ми завжди захищатимемо наполегливу працю та інновації наших команд і вживаємо для цього всіх належних заходів», – заявили у корпорації.

    У матеріалах позову стверджується, що OpenAI нібито створила механізм, який дозволяв отримувати доступ до внутрішніх напрацювань Apple через активне працевлаштування її нинішніх і колишніх співробітників. За версією позивача, йдеться про передачу конфіденційної інформації щодо ще не представлених публіці продуктів, інженерних рішень, виробничих процесів, креслень, архітектури майбутніх пристроїв, інформації про ланцюги постачання, партнерів і постачальників комплектуючих.

    Apple наголошує, що розглядає ці дії як систематичне порушення своїх прав інтелектуальної власності. У позові зазначається, що така практика нібито не була випадковою або поодинокою, а навпаки — підтримувалася всередині нового апаратного підрозділу OpenAI.

    За твердженням Apple, саме завдяки незаконно отриманій інформації OpenAI могла значно скоротити власний цикл досліджень і розробки, отримавши доступ до багаторічних результатів роботи інженерів компанії.

    У відповідь OpenAI категорично відкинула всі звинувачення.

    Представник компанії заявив, що OpenAI не використовує чужі комерційні таємниці та будує власні технології виключно на основі власних досліджень і розробок.

    «Нас не цікавлять комерційні таємниці інших компаній. Ми залишаємося зосередженими на створенні інноваційних технологій, які відкривають нові можливості для людей у всьому світі», – заявили в компанії.

    Позов став черговим етапом загострення конкуренції між Apple та OpenAI, яка останніми роками перетворилася на одного з найвпливовіших гравців світового ринку штучного інтелекту.

    Особливо напруженими відносини між компаніями стали після того, як OpenAI оголосила про намір вийти за межі програмного забезпечення та почати виробництво власних апаратних пристроїв із використанням технологій штучного інтелекту.

    У травні 2025 року компанія придбала за 6,4 мільярда доларів студію io, яку очолює легендарний дизайнер Джоні Айв, який протягом багатьох років відповідав за створення зовнішнього вигляду iPhone, iPad, MacBook та інших культових продуктів Apple.

    Ця угода стала одним із найбільших придбань в історії OpenAI та фактично підтвердила її амбіції вийти на ринок споживчої електроніки, де десятиліттями домінує Apple.

    Після завершення угоди, як стверджує Apple, OpenAI почала активно переманювати її співробітників.

    За інформацією компанії, нині в OpenAI працює понад 400 колишніх працівників Apple.

    Позивач зазначає, що саме масовий перехід інженерів, дизайнерів, спеціалістів із виробництва та менеджерів став підставою для проведення внутрішньої перевірки.

    Apple повідомила, що розпочала власне розслідування ще у лютому.

    Під час перевірки, за твердженням компанії, були виявлені ознаки можливого витоку комерційної інформації.

    Після цього корпорація офіційно звернулася до OpenAI, повідомивши про свої підозри та запропонувавши відреагувати на ситуацію.

    Однак, як стверджує Apple, жодної відповіді компанія так і не отримала.

    У позовній заяві наголошується, що вже виявлені факти можуть бути лише невеликою частиною набагато масштабнішої схеми.

    «Докази, викладені в цьому позові, є лише верхівкою айсберга», – зазначає Apple.

    У компанії також стверджують, що подібна поведінка стала нормою всередині нового апаратного бізнесу OpenAI.

    «Як закономірний результат, новостворений бізнес OpenAI з виробництва апаратного забезпечення зараз спирається на вкрай хиткий фундамент, повністю прогнилий через незаконне використання привласнених комерційних таємниць», – йдеться у судових документах.

    Одним із головних відповідачів у справі є керівник напряму апаратного забезпечення OpenAI Тан Тан.

    За даними Apple, він залишив компанію на початку 2024 року.

    Позивач стверджує, що ще до звільнення Тан нібито передав представникам OpenAI конфіденційну інформацію про мережу постачальників Apple, виробничі процеси та інші внутрішні матеріали.

    Крім цього, Apple заявляє, що після переходу до OpenAI Тан проводив співбесіди з інженерами Apple та використовував уже наявні конфіденційні знання для отримання ще більшого обсягу внутрішньої інформації.

    За версією компанії, таким чином OpenAI могла систематично накопичувати відомості про нові продукти конкурента.

    Другим відповідачем став колишній інженер-електрик Apple Чан Лю.

    За словами позивача, він працював над одними з найсекретніших проєктів компанії та мав доступ до особливо важливої технічної інформації.

    У січні 2026 року він перейшов до OpenAI.

    Apple стверджує, що після звільнення Лю не повернув щонайменше один службовий пристрій та не підтвердив виконання всіх обов’язкових процедур, передбачених внутрішніми правилами компанії.

    У позові також зазначається, що Лю нібито використовував комп’ютер іншої співробітниці Apple для отримання доступу до секретних матеріалів.

    Крім цього, за версією компанії, він інструктував колегу щодо способів копіювання файлів в обхід корпоративних систем захисту.

    Згодом ця співробітниця також перейшла працювати до OpenAI.

    Apple також стверджує, що вже після звільнення Лю використав одну з уразливостей корпоративного мережевого сховища, щоб отримати доступ до конфіденційної інформації, хоча більше не мав відповідних повноважень.

    За даними позову, аналогічні дії нібито здійснювали й інші працівники Apple перед своїм переходом до OpenAI.

    У компанії вважають, що окремі співробітники копіювали службову документацію, технічні файли, креслення та інші матеріали незадовго до звільнення.

    Apple просить суд негайно видати судову заборону, яка не дозволить OpenAI та окремим відповідачам знищувати документи, електронні листування, цифрові носії або будь-які інші потенційні докази.

    Також компанія вимагає зобов’язати відповідачів повернути всі копії комерційних таємниць, конфіденційної документації та інших матеріалів, які, за твердженням Apple, були незаконно привласнені.

    Окрім цього, позивач просить суд стягнути з OpenAI компенсацію завданих збитків або зобов’язати компанію виплачувати роялті у випадку, якщо спірні технології вже використовуються або будуть використані під час створення нових продуктів.

    Цей судовий процес може стати одним із найрезонансніших корпоративних спорів останніх років у технологічній галузі. Якщо викладені у позові звинувачення підтвердяться в суді, справа може мати серйозні наслідки не лише для OpenAI, а й для всієї індустрії штучного інтелекту, де конкуренція за інженерів, інновації та інтелектуальну власність останніми роками суттєво загострилася. Водночас на момент подання позову звинувачення Apple залишаються позицією позивача і мають бути перевірені судом у встановленому законом порядку.

  • Росія хоче обдурити ChatGPT та пошуковики: журналісти розкрили секретний план

    Росія хоче обдурити ChatGPT та пошуковики: журналісти розкрили секретний план

    Російські структури розробляли масштабний проєкт зі створення мережі фейкових сайтів, які мали впливати не лише на пошукові системи, а й на сучасні чат-боти зі штучним інтелектом. Для цього планувалося запускати ресурси, що маскуються під авторитетні медіа, аналітичні центри та довідкові платформи на кшталт енциклопедій.

    Про це йдеться у розслідуванні агентства Bloomberg.

    Журналісти отримали доступ до внутрішніх документів, проєктних пропозицій, скриншотів робочих чатів та інших матеріалів, які демонструють механізми майбутньої інформаційної кампанії.

    За даними розслідування, метою проєкту було створення контрольованого інформаційного середовища, яке потраплятиме до результатів пошукових систем і використовуватиметься великими мовними моделями під час формування відповідей користувачам.

    Фактично йдеться про спробу впливати на штучний інтелект через масове створення псевдоавторитетних джерел інформації.

    У документах згадується розбудова цілої екосистеми сайтів, які зовні нагадують незалежні аналітичні центри, інформаційні агентства та довідкові ресурси. Водночас їхній контент мав формуватися відповідно до російських інформаційних інтересів.

    Окрему увагу організатори приділяли країнам пострадянського простору та регіонам, де Росія прагне зберігати політичний вплив.

    Одним із прикладів став проєкт сайту для Вірменії. Зовні ресурс мав вигляд звичайної довідкової платформи, однак серед матеріалів містилися проросійські публікації та негативні згадки про чинного прем’єр-міністра Вірменії Нікола Пашиняна.

    За даними Bloomberg, подібні ресурси планували використовувати для просування потрібних Кремлю наративів та формування альтернативної інформаційної реальності.

    Окремим напрямком роботи мало стати створення так званих аналітичних центрів. Вони повинні були продукувати дослідження, експертні оцінки та аналітичні матеріали, які згодом цитувалися б іншими ресурсами та потрапляли до інформаційного поля.

    У документах згадується ресурс під назвою “Світовий центр стратегічних досліджень”. Як з’ясували журналісти, частина його матеріалів створювалася на основі вже існуючих публікацій авторитетних видань, однак після редакційної обробки вони отримували вигідний для замовників зміст.

    Експерти зазначають, що подібна стратегія відображає новий етап інформаційних операцій. Якщо раніше головною метою було впливати на аудиторію через соціальні мережі та новинні сайти, то тепер фокус зміщується на алгоритми пошуку та системи штучного інтелекту.

    Сучасні чат-боти та пошукові системи аналізують величезні масиви відкритої інформації. Тому масове створення мережі сайтів із потрібним контентом потенційно може впливати на результати пошуку, рекомендації алгоритмів та відповіді ШІ.

    Фахівці з кібербезпеки наголошують, що подібні кампанії можуть становити серйозну загрозу для інформаційної безпеки, оскільки користувачам стає дедалі складніше відрізнити справжні джерела від штучно створених інформаційних ресурсів.

    У Bloomberg зазначають, що оприлюднені матеріали демонструють прагнення Росії адаптувати свої інформаційні операції до нових технологічних реалій, де ключову роль починають відігравати системи штучного інтелекту.

    На тлі повномасштабної війни проти України російські інформаційні кампанії регулярно стають предметом розслідувань міжнародних медіа та західних спецслужб. Раніше вже повідомлялося про масштабні мережі ботів, фабрики тролів, кампанії дезінформації в соціальних мережах та спроби маніпулювання громадською думкою через цифрові платформи.

    Тепер, як свідчить розслідування Bloomberg, до цього переліку можуть додатися й спроби впливу на штучний інтелект, який дедалі активніше використовується мільйонами людей для отримання інформації.

  • Міністра цифровізації Німеччини запідозрили у використанні ШІ

    Міністра цифровізації Німеччини запідозрили у використанні ШІ

    У Німеччині розгорівся резонансний політичний та медійний скандал навколо міністра цифрових технологій Карстена Вільдбергера, якого запідозрили у системному використанні штучного інтелекту під час підготовки офіційних текстів, промов та публічних заяв. Про це повідомляє агенція dpa, посилаючись на урядові джерела та матеріали журналістських розслідувань.

    Суперечка вибухнула на тлі активного просування Німеччиною політики цифрової трансформації державного сектору, яка передбачає ширше впровадження технологій штучного інтелекту в роботу міністерств, адміністрацій і судової системи. Міністерство цифрових технологій, створене у 2025 році, було одним із ключових інструментів модернізації державного управління, однак саме його очільник тепер опинився в центрі дискусії про межі допустимого використання ШІ на найвищому рівні влади.

    Перші підозри щодо використання алгоритмів виникли після публікації низки виступів і статей, авторство яких приписується Вільдбергеру. Журналісти видання Die Zeit провели аналіз текстів із застосуванням спеціалізованого програмного забезпечення, призначеного для виявлення контенту, згенерованого штучним інтелектом. За їхніми висновками, у матеріалах містяться ознаки машинної генерації, зокрема характерні стилістичні повтори, узагальнені конструкції та структура, притаманна текстам, створеним нейромережами.

    У центрі уваги опинилися не лише публікації в німецьких медіа, а й парламентські промови, а також виступи міністра на міжнародних майданчиках. Зокрема, згадується його промова у 2024 році в аналітичному центрі Атлантичної ради у Вашингтоні, яку деякі експерти назвали такою, що могла бути повністю або частково створена за допомогою штучного інтелекту. Окремі аналітики звернули увагу на нетипову для політичної риторики однорідність формулювань і відсутність індивідуального стилю автора.

    Водночас експерти, залучені до перевірки матеріалів, наголошують, що інструменти для визначення використання ШІ не є абсолютно точними. Вони можуть помилково класифікувати людський текст як згенерований алгоритмами, особливо якщо він редагувався або проходив через кілька етапів автоматичної обробки. Це стало одним із ключових аргументів захисників міністра, які закликають утриматися від передчасних висновків.

    Офіційна позиція міністерства цифрових технологій полягає в тому, що Карстен Вільдбергер справді використовує штучний інтелект у своїй роботі, однак виключно як допоміжний інструмент. Речник відомства заявив, що мова йде про «робочого асистента», який допомагає структурувати думки, редагувати тексти, скорочувати довгі формулювання та пропонувати альтернативні варіанти викладу.

    У міністерстві підкреслюють, що така практика є частиною загальноєвропейського тренду цифровізації державного управління. Там вважають, що державні службовці мають не уникати штучного інтелекту, а навпаки — навчитися ефективно його використовувати. Водночас наголошується, що кожен документ, промова або офіційна заява проходить обов’язкову людську перевірку та затвердження перед публікацією.

    «Штучний інтелект можна розглядати як інструмент для роботи з інформацією — подібно до текстових редакторів чи аналітичних систем. Він допомагає пришвидшити процес підготовки матеріалів, але не замінює політичну відповідальність людини», — зазначили у відомстві.

    Попри це, критики ситуації наголошують, що використання ШІ високопосадовцями може створювати ризики розмивання персональної відповідальності за політичні заяви. Деякі експерти також звертають увагу на можливі проблеми прозорості: громадськість не завжди може відрізнити, де закінчується особиста позиція політика і починається машинна генерація тексту.

    Скандал швидко вийшов за межі суто технічної дискусії і переріс у ширшу політичну дебату про майбутнє штучного інтелекту в державному управлінні. У німецькому суспільстві та медіа почали обговорювати питання, чи повинні політики офіційно декларувати використання ШІ при підготовці своїх виступів і документів, а також чи потрібні нові правові норми для регулювання таких практик.

    На тлі скандалу в Бундестазі вже лунають заклики розробити чіткі правила використання штучного інтелекту в урядових структурах, включно з вимогами до прозорості, фіксації участі ШІ у створенні документів та визначенням меж його застосування.

    Аналітики відзначають, що ця ситуація може стати одним із перших гучних прецедентів у Європі, коли питання використання штучного інтелекту в політиці виходить на рівень загальнонаціональної дискусії і потенційних законодавчих змін.

  • «Чат мертвий»: OpenAI готує радикальне перезавантаження ChatGPT

    «Чат мертвий»: OpenAI готує радикальне перезавантаження ChatGPT

    Американська технологічна компанія OpenAI готує найбільшу трансформацію ChatGPT з моменту запуску сервісу наприкінці 2022 року. Згідно з інформацією Financial Times, компанія планує радикально змінити концепцію свого найвідомішого продукту, перетворивши його з популярного чат-бота на повноцінну платформу цифрових помічників та агентів штучного інтелекту, які зможуть виконувати реальні завдання від імені користувачів. Цей крок розглядається як ключовий елемент нової стратегії OpenAI, яка прагне забезпечити довгострокове зростання доходів, зміцнити свої позиції на ринку та підготуватися до можливого виходу на фондову біржу.

    За останні кілька років ChatGPT став одним із найвідоміших технологічних продуктів у світі. Після запуску у листопаді 2022 року сервіс буквально змінив ставлення суспільства до штучного інтелекту. Якщо раніше технології ШІ залишалися переважно інструментами для вузького кола фахівців, то ChatGPT зробив їх масовими та доступними для сотень мільйонів людей. Саме OpenAI стала компанією, яка фактично запустила глобальний бум генеративного штучного інтелекту, змусивши технологічних гігантів по всьому світу вкладати мільярди доларів у розвиток аналогічних систем.

    Однак успіх ChatGPT приніс компанії не лише популярність, а й нові виклики. Попри величезну аудиторію, яка, за даними видання, вже наближається до одного мільярда користувачів, OpenAI продовжує витрачати колосальні кошти на розвиток своїх моделей. Навчання сучасних систем штучного інтелекту вимагає величезних обчислювальних потужностей, дорогих графічних процесорів, будівництва центрів обробки даних та постійного вдосконалення інфраструктури. На цьому тлі інвестори дедалі частіше очікують від компанії не лише технологічних проривів, а й чіткої стратегії виходу на стабільну прибутковість.

    Саме тому керівництво OpenAI почало переглядати роль ChatGPT у власній екосистемі. Якщо раніше продукт сприймався як інструмент для спілкування зі штучним інтелектом, то тепер його дедалі більше розглядають як своєрідний вхідний портал до ширшого набору сервісів. Усередині компанії формується бачення ChatGPT як універсального цифрового центру, який поєднуватиме різноманітні інструменти для роботи, навчання, програмування, управління завданнями та автоматизації бізнес-процесів.

    Одним із головних напрямків майбутньої трансформації стане розвиток агентів штучного інтелекту. На відміну від звичайних чат-ботів, які переважно відповідають на запити користувачів, агенти здатні самостійно виконувати складні багатокрокові дії. Вони можуть аналізувати інформацію, ухвалювати проміжні рішення, взаємодіяти з іншими сервісами та завершувати поставлені завдання без постійного контролю людини. Саме цей напрямок у OpenAI дедалі частіше називають наступною великою еволюцією індустрії штучного інтелекту.

    У майбутньому такі системи можуть самостійно бронювати авіаквитки та готелі, координувати зустрічі, вести календарі, створювати презентації, працювати з електронною поштою, проводити аналіз документів, готувати звіти або виконувати складні робочі процеси у корпоративному середовищі. Іншими словами, йдеться про перехід від формату «запитання-відповідь» до формату «поставив завдання — отримав готовий результат».

    Особливе місце у новій стратегії відводиться продукту OpenAI Codex. Компанія має намір суттєво збільшити інвестиції в його розвиток, оскільки програмування вважається одним із найбільш перспективних напрямків застосування штучного інтелекту. В останні роки інструменти генерації коду стали одним із найшвидше зростаючих сегментів ринку ШІ. Великі корпорації дедалі активніше впроваджують такі рішення для автоматизації розробки програмного забезпечення, скорочення витрат та підвищення продуктивності команд.

    Саме тому OpenAI поступово зміщує акценти від універсального чат-бота до систем, які здатні виконувати реальну роботу. Показовою стала заява одного зі старших співробітників компанії, якого цитує Financial Times: «Чат мертвий». Ця фраза стала відображенням настроїв усередині OpenAI, де все більше фахівців переконані, що традиційна модель спілкування з чат-ботом уже досягла своєї природної межі розвитку. Наступний етап полягає в тому, щоб штучний інтелект не просто надавав інформацію, а діяв самостійно та приносив практичну користь.

    Такі зміни відбуваються на тлі дедалі жорсткішої конкуренції в галузі. Одним із головних суперників OpenAI залишається Anthropic, яка активно розвиває власну модель Claude та поступово завойовує дедалі більшу частку корпоративного ринку. Водночас значні ресурси у сферу штучного інтелекту вкладають також Google, Microsoft, Meta та інші технологічні гіганти. Конкуренція між ними вже давно вийшла за межі створення найпотужнішої мовної моделі й дедалі більше концентрується навколо побудови цілих екосистем продуктів та сервісів.

    Ще кілька років тому головним завданням OpenAI було переконати людей у можливостях генеративного штучного інтелекту. Сьогодні ж перед компанією стоїть інша мета — перетворити ці технології на стабільний бізнес із прогнозованими доходами. Для цього необхідно створювати продукти, за які готові регулярно платити не лише окремі користувачі, а й великі компанії.

    Саме корпоративний сегмент розглядається як ключове джерело майбутніх прибутків. Бізнес-клієнти потребують інструментів для автоматизації процесів, роботи з великими масивами даних, управління документацією та підвищення ефективності співробітників. Агенти штучного інтелекту, здатні виконувати комплексні завдання без участі людини, потенційно можуть стати одним із найдорожчих і найприбутковіших продуктів на ринку.

    Аналітики зазначають, що якщо OpenAI реалізує свої плани, це може стати найбільшою зміною в історії ChatGPT та одним із найважливіших етапів розвитку всієї індустрії штучного інтелекту. Фактично компанія прагне створити універсального цифрового помічника, який стане невід’ємною частиною повсякденного життя мільйонів людей та робочих процесів тисяч компаній. Якщо раніше користувачі зверталися до ChatGPT за відповідями на запитання, то в майбутньому вони можуть доручати йому виконання повноцінних завдань, залишаючи штучному інтелекту дедалі більше функцій.

    Таким чином OpenAI готує не просто оновлення свого найпопулярнішого продукту, а масштабну трансформацію всієї концепції взаємодії людини зі штучним інтелектом. І саме від успішності цієї стратегії може залежати не лише майбутнє компанії, а й подальший розвиток глобального ринку ШІ, який уже зараз оцінюється у сотні мільярдів доларів і продовжує зростати рекордними темпами.

  • ChatGPT навчився розпізнавати музику: OpenAI інтегрувала Shazam у чат

    ChatGPT навчився розпізнавати музику: OpenAI інтегрувала Shazam у чат

    Компанія OpenAI продовжує активно розширювати можливості свого сервісу ChatGPT. Цього разу розробники інтегрували в систему функції популярного застосунку для розпізнавання музики Shazam. Завдяки цьому користувачі зможуть визначати пісні без необхідності переходити до окремого додатка.

    Про співпрацю повідомило технологічне видання 9to5Mac. Зазначається, що нова функція працюватиме безпосередньо всередині ChatGPT і не вимагатиме встановлення або відкриття Shazam.

    Щоб скористатися новою можливістю, користувачам потрібно перейти до сторінки міні-застосунків у ChatGPT та з’єднати між собою акаунти сервісів. Після цього функція розпізнавання музики стане доступною прямо в чаті зі штучним інтелектом.

    Далі достатньо поставити просте запитання, наприклад: «Що за пісня грає?» або «Чате, що це за пісня?». Після цього система проаналізує звук і повідомить назву композиції.

    У відповіді ChatGPT може показати не лише назву треку, а й ім’я виконавця, обкладинку альбому, а також додаткову інформацію — наприклад, популярність або статистику пошуків пісні.

    Розробники зазначають, що ця функція стане частиною звичайного діалогу з чат-ботом. Користувачі зможуть продовжувати спілкування, ставити додаткові запитання або просити знайти інші композиції без необхідності відкривати сторонні сервіси.

    Інтеграція розпізнавання музики є ще одним кроком у розвитку ChatGPT як універсального цифрового помічника, який поступово об’єднує функції різних сервісів у межах одного застосунку.

  • Коли закінчиться мобілізація: що прогнозує штучний інтелект

    Коли закінчиться мобілізація: що прогнозує штучний інтелект

    В Україні тривають воєнний стан і загальна мобілізація чоловіків віком від 25 до 60 років. Окрім обов’язкового призову, громадяни можуть добровільно укласти контракт зі Збройними силами України. Нещодавно з’явилася також ініціатива «контракт 60+», яка дозволяє долучатися до служби чоловікам старшого віку, що раніше не підпадали під мобілізацію.

    На тлі затяжної війни багатьох українців хвилює питання: коли можуть завершитися мобілізація та воєнний стан. Для розважального експерименту журналісти звернулися до штучного інтелекту з проханням спрогнозувати можливі сценарії розвитку подій.

    За оцінкою ChatGPT (модель GPT-5), скасування мобілізації безпосередньо залежить від припинення або суттєвого зниження інтенсивності бойових дій. Серед ключових факторів — стабільність лінії фронту, обсяг міжнародної військової допомоги, економічна стійкість держави та готовність сторін до реальних домовленостей.

    ШІ вказує на три умови, за яких можливе скасування воєнного стану:
    стабільне припинення вогню;
    заморожування конфлікту з міжнародними гарантіями безпеки;
    завершення активної фази війни.

    Станом на початок 2026 року, на думку моделі, жодна з цих умов повністю не виконана. Війна, за оцінкою алгоритму, має ознаки затяжного протистояння без стратегічної переваги жодної зі сторін.

    ChatGPT вважає, що у 2026 році скасування мобілізації малоймовірне. Найбільш реалістичний сценарій, за версією ШІ, — поступове пом’якшення мобілізаційних заходів у 2027 році за умови стабілізації фронту та появи реальних міжнародних гарантій. Повне скасування можливе лише після обмеження масштабів призову та переходу до іншої моделі комплектування армії.

    Водночас модель допускає і жорсткіший сценарій — збереження режиму воєнного стану до 2028 року і довше, якщо війна залишатиметься у фазі виснаження.

    Інша система штучного інтелекту — Claude — утрималася від точних прогнозів, зазначивши, що не може передбачати майбутнє. Проте, аналізуючи поточну політичну ситуацію, вона оцінила ймовірність завершення війни до літа 2026 року на рівні 20–30%.

    Серед можливих сценаріїв Claude називає укладення мирної угоди. У такому випадку, за умов досягнення домовленостей та гарантій безпеки, воєнний стан можуть скасувати через 3–6 місяців після підписання угоди. Мобілізація при цьому згорталася б поступово, із збереженням регулярного комплектування армії.

    Водночас матеріал має виключно розважальний характер. Штучний інтелект здатен аналізувати відкриті дані та моделювати сценарії, однак його оцінки не є офіційними прогнозами чи підставою для прийняття рішень.

  • У безоплатному ChatGPT з’явиться реклама

    У безоплатному ChatGPT з’явиться реклама

    У безоплатній версії ChatGPT та моделі Go незабаром з’явиться реклама. Користувачі платних підписок продовжать користуватися сервісом без рекламного контенту.

    Представники OpenAI запевняють, що реклама не вплине на якість відповідей чат-бота. Також компанія наголосила, що рекламодавці не отримають доступ до листування користувачів із системою, тож приватність особистих даних залишиться непорушною.

    Впровадження реклами має на меті зробити безоплатну версію більш доступною для широкого кола користувачів, зберігаючи при цьому комерційний стимул для розвитку платних підписок.

    Представники OpenAI зазначили, що формат рекламного контенту буде обмеженим і не буде втручатися у функціонал чат-бота, а користувачі зможуть продовжувати отримувати корисні відповіді й рекомендації без додаткових обмежень.