Позначка: нейромережі

  • Google запускає музей, у якому картини генерує ШІ

    Google запускає музей, у якому картини генерує ШІ

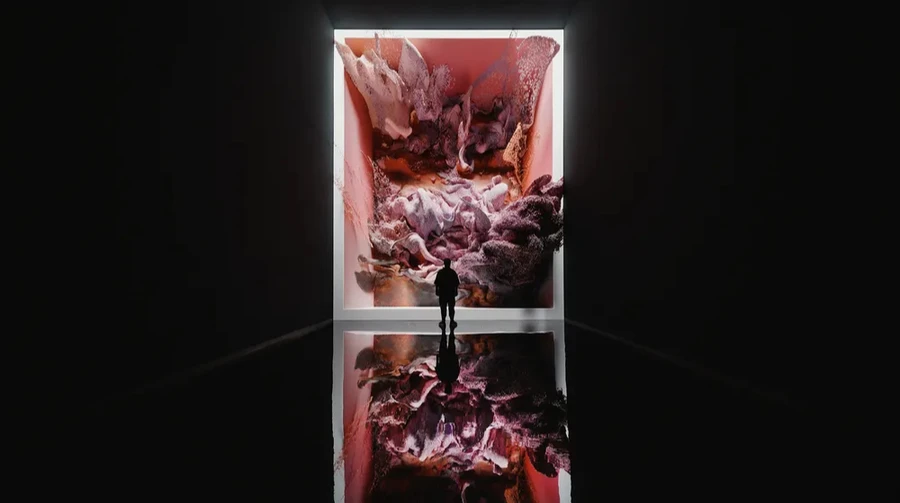
    Google оголосила про запуск масштабного культурно-технологічного проєкту Dataland, який позиціонується як перший у світі музей мистецтва, повністю присвячений штучному інтелекту. Відкриття заплановане на 20 червня в Лос-Анджелесі, і, за задумом розробників, новий простір має стати не просто виставковою залою, а експериментальною платформою, де мистецтво створюється, змінюється та “оживає” у режимі реального часу завдяки алгоритмам машинного навчання.

    Проєкт Dataland розміщений у будівлі The Grand LA, яку спроєктував всесвітньо відомий архітектор Френк Гері, і займає площу приблизно 2,3 тисячі квадратних метрів. Архітектура простору відіграє важливу роль у концепції музею, оскільки він задуманий як повністю інтерактивне середовище, де технології та фізичний простір зливаються в єдину систему сприйняття. Ініціатива реалізується у співпраці Google з медіахудожником Рефіком Анадолом, який відомий своїми роботами на перетині штучного інтелекту, нейромереж та цифрового мистецтва.

    Центральною частиною відкриття стане виставка під назвою “Machine Dreams: Rainforest”, яка демонструватиме зображення, створені штучним інтелектом у режимі реального часу. Система генерує візуальні сцени з надзвичайно високою деталізацією, що, за заявами організаторів, досягає роздільної здатності до 1,2 мільярда пікселів. Ці цифрові “ландшафти” не є статичними творами, а постійно змінюються, реагуючи на алгоритмічні процеси та зовнішні фактори, що робить кожен візит відвідувача унікальним досвідом.

    Окрім візуальної складової, музей використовує складну багаторівневу систему взаємодії з аудиторією. Простір оснащений сенсорами, які аналізують рухи, присутність та реакції відвідувачів, формуючи адаптивне середовище, що змінює як звуковий супровід, так і візуальні елементи експозиції. Додатково система здатна генерувати ароматичні композиції, що перетворює музейний простір на повністю сенсорний досвід, де задіяні зір, слух і нюх одночасно.

    У Google пояснюють, що технологічною основою Dataland є моделі Gemini, які працюють на інфраструктурі Google Cloud. Це означає, що створення художнього контенту відбувається не локально, а у глобальних датацентрах компанії, після чого результат у реальному часі транслюється до музейного простору. Така архітектура дозволяє безперервно оновлювати експозицію, фактично перетворюючи музей на живу систему, яка ніколи не повторюється у тому самому вигляді.

    Запуск Dataland відбувається на тлі тривалої дискусії у світовому мистецькому середовищі щодо статусу творів, створених штучним інтелектом. Частина критиків вважає такі роботи інструментальним продуктом алгоритмів, тоді як інші розглядають їх як нову форму креативності, де людина виступає куратором або співтворцем, а не єдиним автором. У Google фактично займають позицію на користь другого підходу, просуваючи ідею ШІ як повноцінного учасника творчого процесу.

    Паралельно з відкриттям музею запускається програма AI Artist Residency, реалізована платформою Google Arts & Culture. Вона передбачає гранти у розмірі 25 тисяч доларів для митців, які працюють із технологіями штучного інтелекту, а також менторську підтримку від студії Refik Anadol Studio і доступ до інструментів машинного навчання Google. Протягом року роботи учасників програми планують демонструвати як у самому Dataland, так і на цифрових платформах компанії.

    Таким чином Dataland фактично поєднує в собі одразу кілька функцій — музей, дослідницьку лабораторію, художню платформу та технологічний демонстраційний центр. Експерти вже називають цей проєкт спробою переосмислити саму концепцію музею як інституції, де замість статичних експонатів існують динамічні цифрові системи, що постійно змінюються під впливом алгоритмів і взаємодії з людьми.
  • Україна будує свій “цифровий мозок”: як створюють національний ШІ

    Україна будує свій “цифровий мозок”: як створюють національний ШІ

    Півтора року тому Україна зробила стратегічну заявку на входження в глобальну гонку штучного інтелекту не лише як споживач технологій, а як держава, що намагається створити власну фундаментальну AI-інфраструктуру. У центрі цієї амбіції опинилася ідея національної великої мовної моделі — LLM, яка має стати не просто черговим цифровим сервісом, а базовим шаром для державних продуктів, взаємодії громадян із сервісами та навіть елементом аналітичної й безпекової екосистеми країни.

    Ініціатором проєкту виступило Міністерство цифрової трансформації, яке на тлі стрімкого розвитку глобальних моделей на кшталт GPT чи Gemini фактично поставило питання суверенності даних і технологій. Логіка проєкту проста: якщо штучний інтелект дедалі більше впливає на економіку, управління, оборону та освіту, то країна, яка не має власної моделі або контролю над нею, опиняється в технологічній залежності. Саме тому в Україні було ухвалено рішення розпочати створення власної LLM, що отримала назву «Сяйво».

    Початкові очікування були доволі оптимістичними. Уряд розраховував, що перші результати можна буде показати вже наприкінці 2025 року, а навесні 2026 року модель стане доступною для публічного тестування. Однак у міру занурення в технічну реалізацію стало очевидно, що проєкт значно складніший, ніж виглядав на рівні концепції. Строки почали зсуватися, а сама архітектура проєкту — змінюватися.

    Важливу роль у реалізації відіграло партнерство Мінцифри з компанією «Київстар», яке було оформлене у вигляді державно-приватної моделі. Саме оператор мобільного зв’язку взяв на себе фінансування, формування технічної команди та частину інженерної розробки, тоді як держава відповідала за координацію, доступ до даних і формування етичних та правових рамок. Такий підхід мав пришвидшити запуск, однак на практиці виявився складнішим через високу складність самої технології.

    Однією з перших серйозних проблем стала робота з даними. Для навчання великої мовної моделі потрібні величезні масиви текстів, і хоча Україна має значний інформаційний ресурс у вигляді архівів, медіа, наукових робіт і державних документів, значна частина цих матеріалів або юридично захищена, або фізично не оцифрована. Це створило додатковий пласт роботи, який не був повністю врахований на старті. Паралельно виникла необхідність створити систему анонімізації, очищення даних і юридичної перевірки, щоб уникнути порушення авторських прав і захистити персональну інформацію.

    Ще одним викликом став кадровий дефіцит. Фахівців із досвідом саме у тренуванні великих мовних моделей в Україні небагато, а глобальний ринок таких спеціалістів є надзвичайно конкурентним. Частину команди довелося формувати з інженерів суміжних напрямів, яких додатково навчали специфіці LLM-розробки. Формування повноцінної команди розтягнулося на місяці, а паралельно до роботи залучалися зовнішні експерти та консультанти.

    Технічна складність проєкту також виявилася вищою за очікування. Українська LLM будується не на класичних для індустрії Nvidia GPU, а на інфраструктурі Google TPU, що вимагало адаптації інструментів і підходів до тренування. Це означало не лише інший стек технологій, а й необхідність перебудови частини пайплайнів навчання моделей.

    Наразі проєкт перебуває на етапі завершення роботи над першою, малою моделлю з приблизно чотирма мільярдами параметрів. Вона не призначена для масового використання, а виконує роль технічного полігону, на якому відпрацьовуються всі ключові процеси: від підготовки даних до оцінки якості відповідей та поведінки системи в складних сценаріях. Саме на цьому етапі команда тестує так званий alignment — налаштування моделі так, щоб вона коректно реагувала на чутливі, складні або потенційно небезпечні запити, не виходячи за межі безпечної поведінки.

    За словами учасників проєкту, ця фаза є критично важливою, оскільки дозволяє уникнути дорогих помилок на наступному етапі, коли йтиметься про значно більшу модель. Малу версію планують завершити як технічний етап у другій половині року, після чого команда перейде до створення повноцінної великої LLM, яка вже буде орієнтована на практичне використання.

    Концепція великої моделі також зазнала змін. Якщо спочатку передбачалося поетапне створення трьох рівнів — малої, середньої та великої моделей, то тепер команда вирішила пропустити проміжну стадію і рухатися безпосередньо до масштабної системи. Базою для неї має стати сучасна модель Google Gemma 4, яка значно перевершує попередні версії за показниками логічного мислення, математичних задач і здатності працювати з довгими контекстами.

    Втім, перехід на нову архітектуру додав складності. Уже створений український токенайзер, який оптимізував роботу з українською мовою, тепер потрібно адаптувати до нової моделі. Це фактично означає повторну частину роботи, але з урахуванням уже отриманого досвіду.

    Окремий акцент у проєкті зроблено на українській мові як такій. Сьогодні більшість глобальних моделей опрацьовують українські запити через англомовний «проміжний шар», коли текст спочатку фактично перекладається, а вже потім обробляється. Це призводить до втрати нюансів, стилістики та частини змісту. Щоб уникнути цього, команда формує спеціалізовані українськомовні корпуси даних обсягом у десятки терабайтів і створює механізми, які дозволяють моделі працювати з мовою напряму, без перекладацького посередника.

    Паралельно вибудовується і правова архітектура проєкту. Україна залучає десятки державних і недержавних інституцій до формування датасетів, включаючи медіа, університети, видавництва та архіви. При цьому застосовуються механізми очищення даних від персональної інформації та чутливих відомостей, а також формується система національних бенчмарків, яка має оцінювати не лише точність, а й етичність роботи моделі.

    На рівні інфраструктури держава паралельно будує власну AI-систему, яка має забезпечити автономність у тренуванні та використанні моделей. Йдеться про проєкт AI Factory, який передбачає створення GPU-вузлів, систем охолодження та сховищ даних для роботи зі складними обчисленнями. Частину обладнання вже закуплено, а в перспективі інфраструктура має розширитися до десятків обчислювальних кластерів.

    Попри всі складнощі, у проєкті зберігається оновлений графік. Очікується, що велика українська LLM може бути готова до тестування приблизно наприкінці 2026 року. Після цього її планують передати державі, а згодом розгорнути всередині країни, перенісши з хмарних сервісів на національну інфраструктуру.

    Фактично Україна намагається одночасно вирішити три завдання: наздогнати глобальний розвиток штучного інтелекту, створити власну мовну модель і закласти основу для цифрового суверенітету. Це складний і довготривалий процес, у якому технологічні виклики переплітаються з юридичними, кадровими та інституційними. Але саме від того, наскільки успішно він буде реалізований, залежить, чи стане Україна не лише користувачем глобальних AI-систем, а й їхнім повноцінним розробником.